前回の記事では後ろ向きの歩行に成功しました。
ただ、
- base の policy の横移動・旋回を忘却しており、転倒した
- 歩行がぎこちなかった
といった問題がありました。
前回の記事ではテストのために 60 秒程度の短い学習時間としましたが、今回は安定した歩行を目的として学習時間を長くしてみます。
準備
今回は前回と humanoid repository のソースコードは変えてないです。
humanoid repository の準備
cd ~/lab
git clone git@github.com:remmaTech12/humanoid.git
cd humanoid
git checkout 0.0.3
IsaacLab repository の準備
cd ~/lab
git clone https://github.com/isaac-sim/IsaacLab.git
cd IsaacLab
source .venv/bin/activate
を忘れずに。
学習
実際 keyboard.py で呼び出している policy (Isaac-Velocity-Flat-G1-v0/checkpoint.pt) は ChatGPT の推定で、
num_envs x num_steps_per_env x max_iterations
  = 4096 x 24 x 1500
  = 147,456,000 environment steps
程度の step 数で学習されています。各パラメータの意味は以下。
num_envs= 並列に動かす environment / robot の数num_steps_per_env= 1 回の PPO update の前に、各 environment から収集する RL step 数max_iterations= 「各 environment でnum_steps_per_env分の経験を収集 → PPO update」という処理を何回繰り返すか
今回は追加学習であることも加味して、この半分くらいの step 数で学習します。以下のコマンドのように、--num-envs を 4096 の半分の 2048 にしています。
cd ~/lab/humanoid
python isaac/g1/train.py \
  --checkpoint ~/lab/IsaacLab/.pretrained_checkpoints/rsl_rl/Isaac-Velocity-Flat-G1-v0/checkpoint.pt \
  --policy-name backward \
  --vx -1.0 1.0 \
  --vy -0.5 0.5 \
  --wz -1.0 1.0 \
  --learning-rate 1e-3 \
  --num-envs 2048 \
  --max-iterations 1500 \
  --save-interval 100
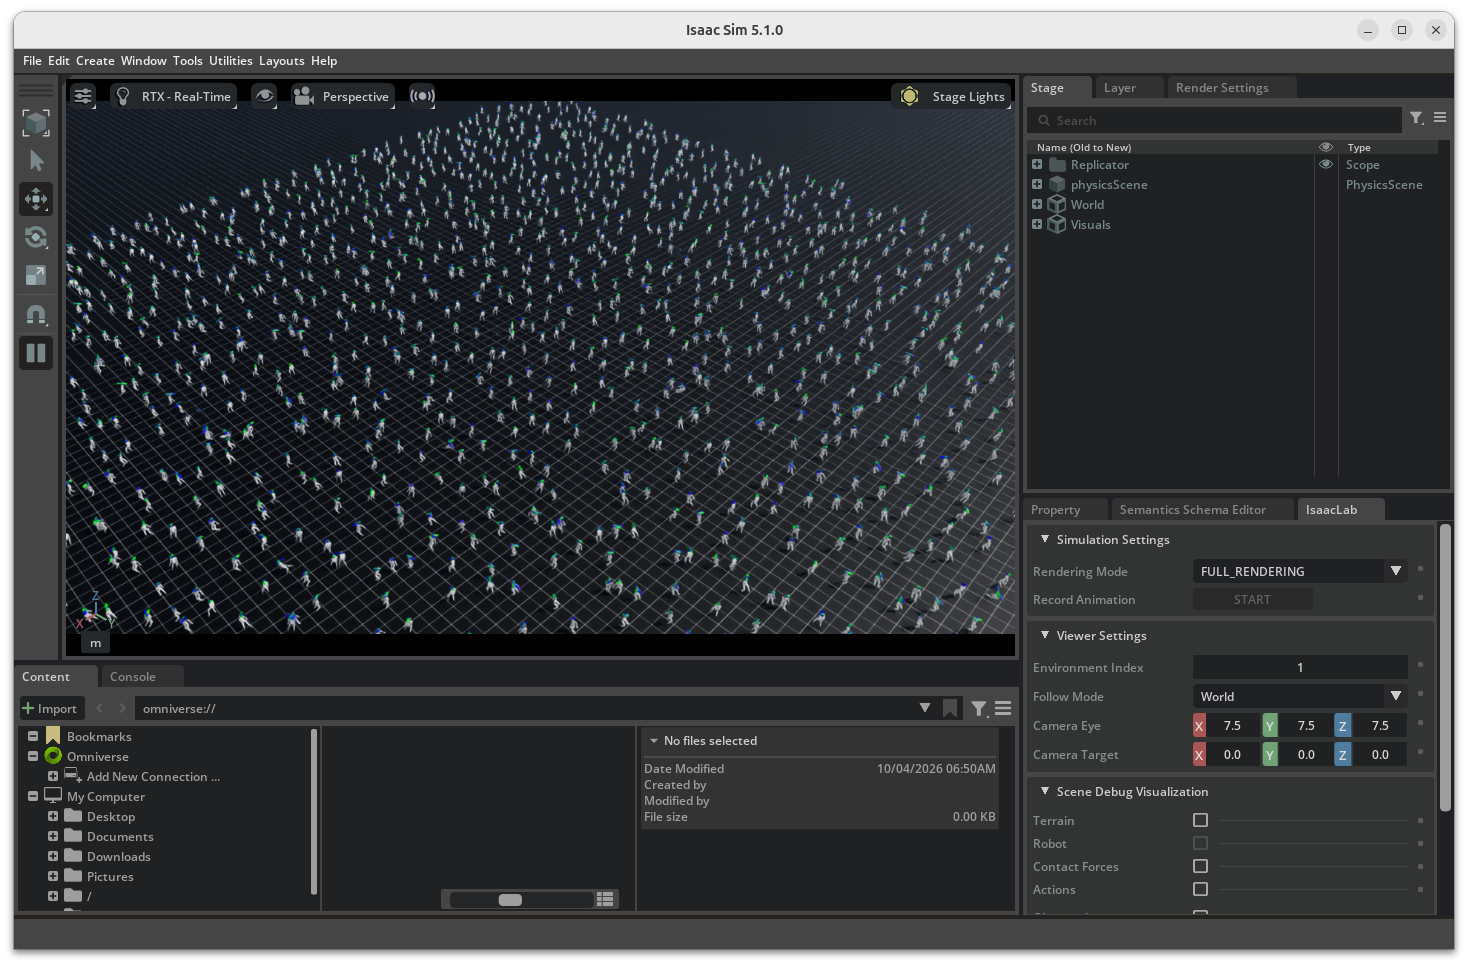
2048 体のロボットを spawn すると絵面としてはすごいことになります。
推論
以下のコマンド実行で、1499 iteration 目の checkpoint の policy でだいぶ安定した歩行ができていることを確認できました!後ろ向きだけでなく、前方、横方向、旋回も。
python3 isaac/g1/keyboard.py --checkpoint isaac/g1/policies/backward/2026-10-04_06-53-02/model_1499.pt考察
ところで、本当に 1500 の iteration が必要なのでしょうか?
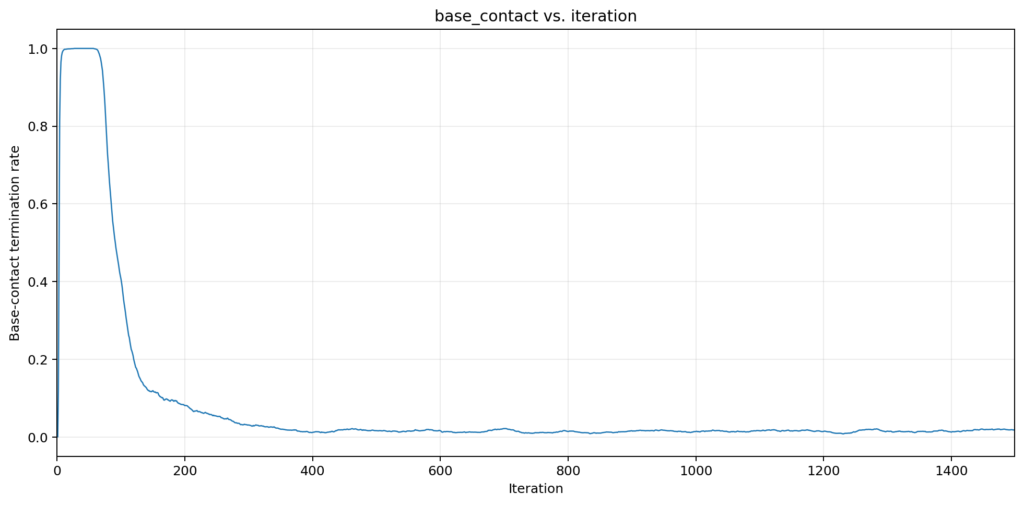
| iteration | Mean reward | error_vel_xy | error_vel_yaw | base_contact |
|---|---|---|---|---|
| 100 | 2.39 | 0.5312 | 2.7738 | 0.4062 |
| 500 | 18.94 | 0.2849 | 0.8779 | 0.0161 |
| 1000 | 21.69 | 0.2579 | 0.7128 | 0.0140 |
| 1250 | 21.49 | 0.2623 | 0.6915 | 0.0131 |
| 1499 | 21.60 | 0.2570 | 0.6734 | 0.0190 |
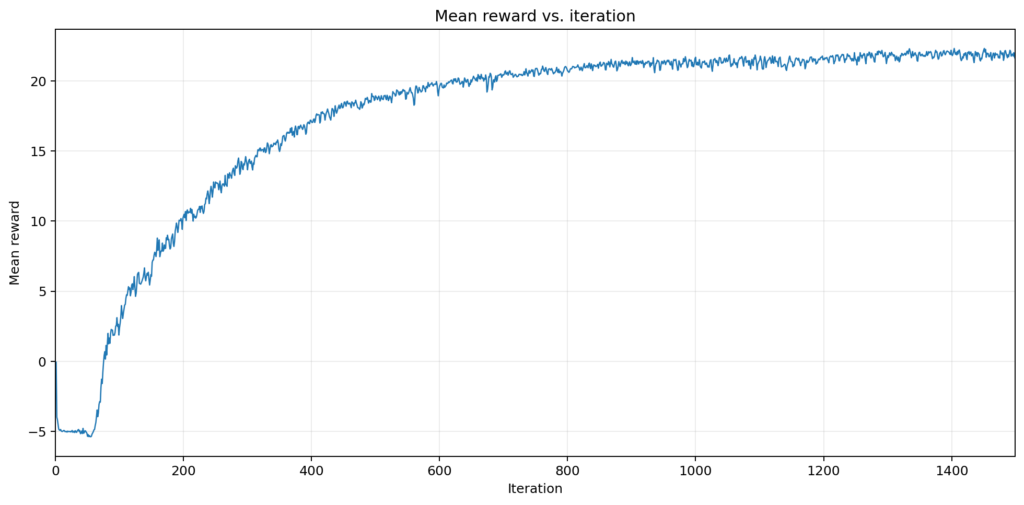
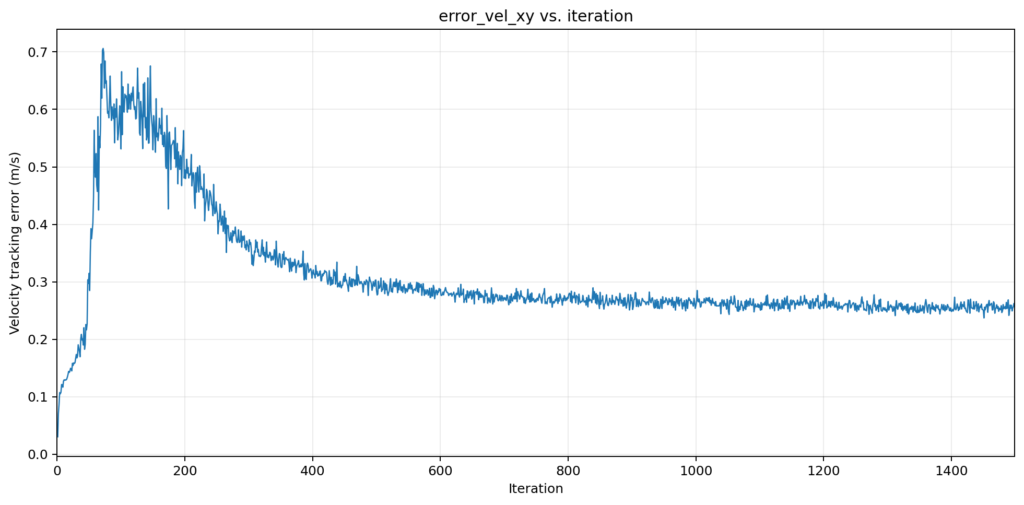
上記の表を見ると、1000 iteration 目あたりで reward が収束しつつあり、base_contact(転倒確率)も減り、速度指令と実際のロボットの速度差(error_vel_*)も小さくなっているため、1000 iteration 目の policy で十分なのではないかという推測が立ちます。
後方、前方、左、右、時計回り、反時計回りのコマンドを送ったときの動作結果を、100 iteration 目、500 iteration 目、1000 iteration 目の policy でそれぞれ確認してみます。
100 iteration 目
100 iteration 目では全然安定している感じがしません。平行移動中もなぜか回っちゃってますね..笑
500 iteration 目
100 iteration よりはだいぶ安定している感じがありますが、まだ後ろ歩きが少しぎこちない感じしますね…。
1000 iteration 目
1000 iteration で 1499 iteration の policy とほぼ同様の歩行動作をしていることがわかります。安定な後ろ向きの歩行を実現するという観点では、1000 iteration で十分というのが今回の結論です。
reward, error_vel_*, base_contact の推移グラフも見てみましょう。reward, error_vel_* に関しては 1499 iteration 目でもまだ変位しそう(収束しきっていなそう)なので、もう少し学習を回すとさらに歩行が安定する可能性もあります。
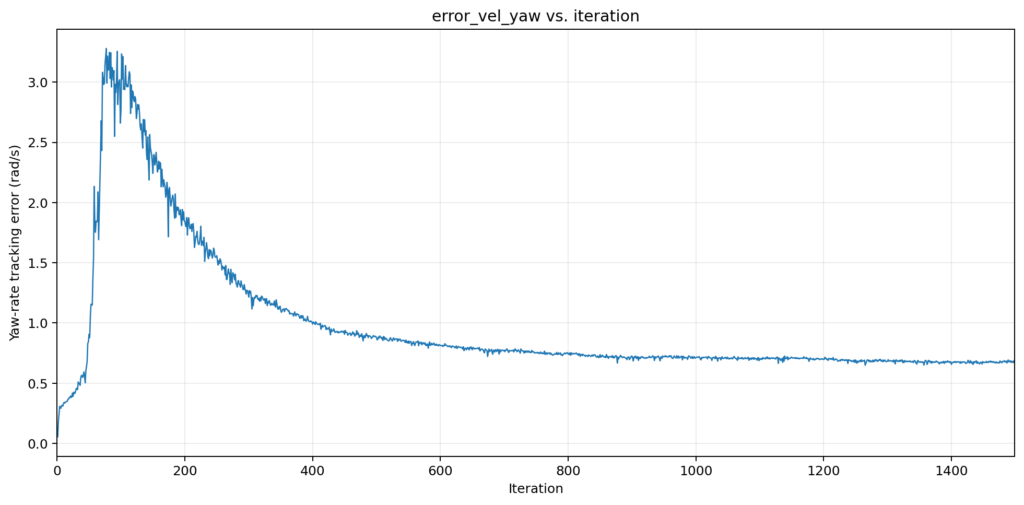
また、後ろ向き歩行時には、ロボットがわずかに時計回りへ旋回しているようにも見えます。今回の学習では yaw 方向の速度追従も reward に含まれていますが、後退時の直進性は十分に学習できていない可能性があります。改善するためには、後退かつ wz = 0 の command をより多く学習させる、あるいは yaw 方向の速度追従に関する reward の重みを調整するなど、学習条件や reward 設計を見直す必要がありそうです。
まとめ
- 学習 step 数を多くすることで安定した全方向の歩行を実現することができた
- 安定した歩行の観点では 1000 iteration で十分。これは学習指標から説明がつく。
- 後退時の意図しない yaw 方向回転が観測された。改善するためには reward 再設計や学習条件の見直しが必要かも
コメント