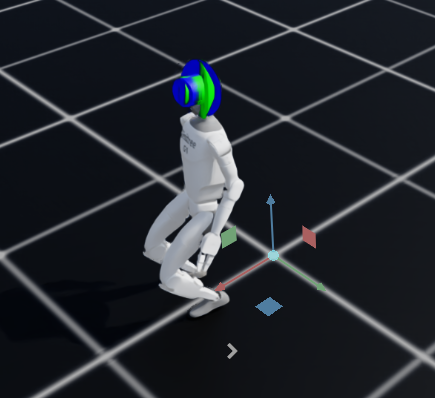
前回までの記事で、とりあえず IsaacLab を使って強化学習で歩行 policy を生成することができました。ただ、前回の policy は新規学習でありかつ短めの学習時間だったので、ほぼ歩けませんでした。
今回は前々回の記事で後ろ向きの歩行ができなかったことを改善するための記事になります。
準備
前回の記事では以下コマンドで学習を行ったのですが、
cd ~/lab/IsaacLab
./isaaclab.sh -p scripts/reinforcement_learning/rsl_rl/train.py \
  --task Isaac-Velocity-Flat-G1-v0 \
  --num_envs 64 \
  --max_iterations 50 \
  --run_name test
以下の理由から、学習用 script を humanoid repository につくりました。
- fine tuning で checkpoint 指定をするためにはコード修正が必要だった
- policy の保存場所を任意の場所に変更したかった
- コード修正なしで学習用の velocity range を指定したかった
version 0.0.3 をリリースしており、上記の問題に対処した train.py という script を用意しているのでお使いください。
cd ~/lab/humanoid
git fetch
git checkout 0.0.3
学習
python isaac/g1/train.py \
  --checkpoint ~/lab/IsaacLab/.pretrained_checkpoints/rsl_rl/Isaac-Velocity-Flat-G1-v0/checkpoint.pt \
  --policy-name backward \
  --vx -0.4 -0.1 \
  --vy 0.0 0.0 \
  --wz 0.0 0.0 \
  --learning-rate 1e-3 \
  --num-envs 64 \
  --max-iterations 500 \
  --save-interval 50
上記スクリプトにより、前回 keyboard.py で歩行できた policy をベースとして、速度指令値の範囲を vx = -0.4 ~ -0.1 m/s、vy = 0.0 m/s、wz = 0.0 rad/s に設定して fine tuning をします。
学習中の様子はこんな感じです。以下は、Learning Iteration 380 くらいでだいぶ転倒しなくなったタイミングでの動画です。
ちなみに上記の動画では、黄緑が目標速度、青が実速度を表しているようです。
最初の方はロボットが倒れまくっていました。倒れたことを検知した場合、base_contact が 1 になるのですが、学習を進めていくとこの値が徐々に小さくなっていきます。最終的には 0.2188 となっており、これは base contact による episode 終了の割合が約 21.9 % まで低下したことを意味します。
################################################################################
                       Learning iteration 499/500

                       Computation: 1630 steps/s (collection: 0.906s, learning 0.037s)
             Mean action noise std: 0.61
          Mean value_function loss: 0.0159
               Mean surrogate loss: -0.0228
                 Mean entropy loss: 19.9426
                       Mean reward: 11.84
               Mean episode length: 890.75
Episode_Reward/track_lin_vel_xy_exp: 0.7178
Episode_Reward/track_ang_vel_z_exp: 0.3793
       Episode_Reward/lin_vel_z_l2: -0.0094
      Episode_Reward/ang_vel_xy_l2: -0.0276
     Episode_Reward/dof_torques_l2: -0.0098
         Episode_Reward/dof_acc_l2: -0.0119
     Episode_Reward/action_rate_l2: -0.1474
      Episode_Reward/feet_air_time: 0.0300
Episode_Reward/flat_orientation_l2: -0.0263
     Episode_Reward/dof_pos_limits: -0.0112
Episode_Reward/termination_penalty: -0.0750
         Episode_Reward/feet_slide: -0.0120
Episode_Reward/joint_deviation_hip: -0.0528
Episode_Reward/joint_deviation_arms: -0.0561
Episode_Reward/joint_deviation_fingers: -0.0652
Episode_Reward/joint_deviation_torso: -0.0167
Metrics/base_velocity/error_vel_xy: 0.4003
Metrics/base_velocity/error_vel_yaw: 1.0933
      Episode_Termination/time_out: 0.7812
  Episode_Termination/base_contact: 0.2188
--------------------------------------------------------------------------------
                   Total timesteps: 768000
                    Iteration time: 0.94s
                      Time elapsed: 00:07:55
                               ETA: 00:00:00
推論
上記によって、humanoid/isaac/g1/policies/backward/2026-10-03_20-31-39/model_499.pt という policy が生成されました。以下のコマンドで、この policy を使った推論をします。
python isaac/g1/keyboard.py \
  --vx 0.2 \
  --checkpoint isaac/g1/policies/backward/2026-10-03_20-31-39/model_499.pt
vx の速度指令範囲は -0.4m/s ~ -0.1m/s としたので、その範囲に収まるように vx(前方後方指令の絶対値)を 0.2m/s としています。
見てわかるように、後ろ方向の学習は成功しているようで、ちゃんと後方に歩けています(だいぶぎこちないですが)。
ただ、学習 step が少ないことによりだいぶ歩行がぎこちなかったり、後ろ並進方向の学習しか追加学習に含めていないため、横方向や旋回時にロボットが倒れてしまっていることがわかります。
次回は、まともな歩行 policy を生成するためにはどれくらいの追加学習が必要なのか(範囲・step 数含め)を算出していきたいと考えています。
まとめ
- 500 回の learning iteration により、ぎこちない動きではあるが後ろ方向の歩行を実現できた
- 後ろ方向の歩行指令しか学習時に含めていなかったため、横方向動作や旋回動作を忘却してしまった
コメント