今回は歩行 policy の学習方法を書きます。お試しなので、この policy で歩行はできないのですが、ざっくり概要だけ。
前回までの記事で、keyboard で歩行操作ができるようになっています。
学習
今回は、以下のコマンドを実行します。IsaacSim / IsaacLab の環境構築が済んでいることを前提としています(link)。
cd ~/lab/IsaacLab
./isaaclab.sh -p scripts/reinforcement_learning/rsl_rl/train.py \
  --task Isaac-Velocity-Flat-G1-v0 \
  --num_envs 64 \
  --max_iterations 50 \
  --run_name test
分解して理解していきましょう。
scripts/reinforcement_learning/rsl_rl/train.py- RSL-RL の PPO (Proximal Policy Optimization) 学習を回す script です。
--task Isaac-Velocity-Flat-G1-v0- Unitree G1
- flat terrain
- velocity tracking
- -> の学習環境を使います。
--num_envs 64- G1 を 64 体並列でシミュレーションします。
- 各 env で経験を集めて、まとめて PPO 更新に使います。
--max_iterations 50- PPO の learning iteration を 50 回だけ回します。
- テスト向けのかなり短い設定です。
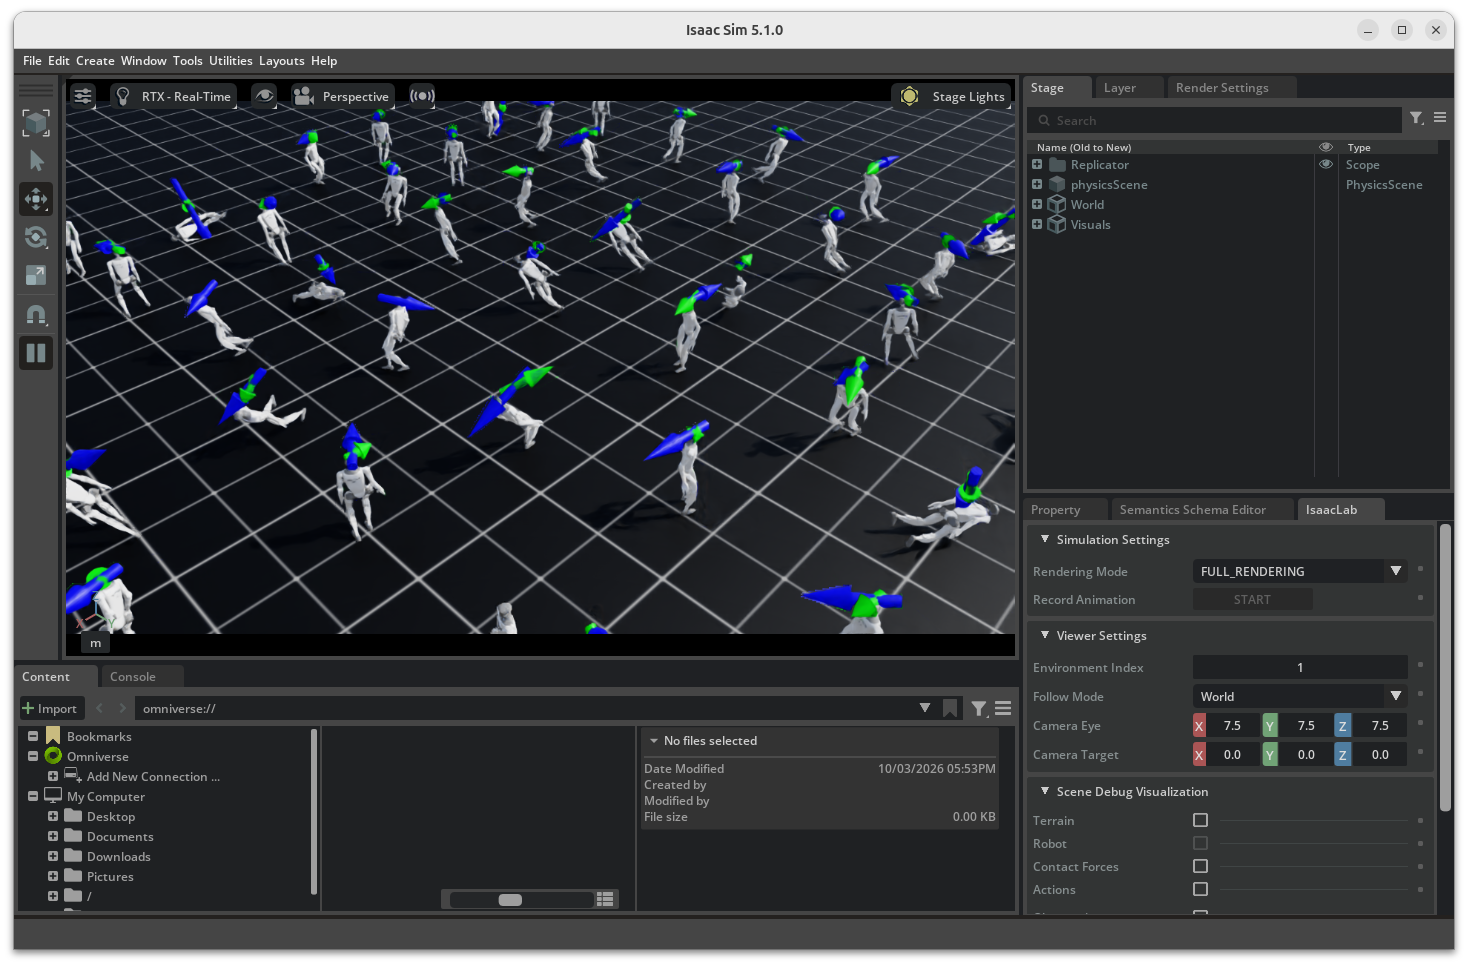
上記を実行すると、以下のように学習が走り始めます。ちょっと気持ち悪いですね🕷
私の環境だと 1 分ちょっとで終わりました。
# 中略
################################################################################
                        Learning iteration 49/50

                       Computation: 1493 steps/s (collection: 0.993s, learning 0.036s)
             Mean action noise std: 1.00
          Mean value_function loss: 0.0146
               Mean surrogate loss: -0.0481
                 Mean entropy loss: 52.5115
                       Mean reward: -5.82
               Mean episode length: 39.06
Episode_Reward/track_lin_vel_xy_exp: 0.0080
Episode_Reward/track_ang_vel_z_exp: 0.0025
       Episode_Reward/lin_vel_z_l2: -0.0022
      Episode_Reward/ang_vel_xy_l2: -0.0489
     Episode_Reward/dof_torques_l2: -0.0024
         Episode_Reward/dof_acc_l2: -0.0052
     Episode_Reward/action_rate_l2: -0.0163
      Episode_Reward/feet_air_time: 0.0002
Episode_Reward/flat_orientation_l2: -0.0136
     Episode_Reward/dof_pos_limits: -0.0003
Episode_Reward/termination_penalty: -0.2000
         Episode_Reward/feet_slide: -0.0047
Episode_Reward/joint_deviation_hip: -0.0028
Episode_Reward/joint_deviation_arms: -0.0036
Episode_Reward/joint_deviation_fingers: -0.0020
Episode_Reward/joint_deviation_torso: -0.0010
Metrics/base_velocity/error_vel_xy: 0.0953
Metrics/base_velocity/error_vel_yaw: 0.4794
      Episode_Termination/time_out: 0.0000
  Episode_Termination/base_contact: 1.0000
--------------------------------------------------------------------------------
                   Total timesteps: 76800
                    Iteration time: 1.03s
                      Time elapsed: 00:00:50
                               ETA: 00:00:01

Training time: 51.31 seconds
[66.762s] Simulation App Shutting Down
推論
上記が終わると、~/lab/IsaacLab/logs/rsl_rl/g1_flat/2026-10-03_17-53-32_test/model_49.pt という policy が出来上がり、この policy を使って歩行ができるわけです。
前回同様、humanoid repository で今回学習した policy を動かしてみましょう(まぁほとんど学習できてないので歩けないのですが)!
cd ~/lab/humanoid
git checkout 0.0.2
python3 isaac/g1/keyboard.py --checkpoint ~/lab/IsaacLab/logs/rsl_rl/g1_flat/2026-10-03_17-53-32_test/model_49.pt
歩けないことの確認ができました!笑
まとめ
- IsaacLab での歩行 policy の強化学習方法をまとめた。
- 短い step 数の学習では歩けないことをしめした。
コメント